Du åpner kodeprosjektet, velger en KI-modell og gir den en oppgave. Men hvilken modell bør få jobben når endringen berører både databasen, forretningslogikken og testene? September har gitt utviklere flere nye alternativer — og flere tall å tolke.
Grok 4.7 er kommet til Cursor. Google har lansert Gemini 3.8 Flash og nye modeller for samtaler i sanntid. Her ser vi på hva som faktisk er nytt, hvordan benchmarkene bør leses, og hvordan du kan sammenligne modellene på arbeid som betyr noe for deg.
Oppdatert 22. september 2026. Artikkelen bygger på leverandørenes dokumentasjon og publiserte tester fra Artificial Analysis. Kodemagisk har ikke gjennomført en egen sammenlignende produkttest.
Grok 4.7: en ny kandidat for krevende kodeoppgaver
SpaceXAI lanserte Grok 4.7 den 21. september. Selskapet beskriver en større grunnmodell og trening rettet mot oppgaver som krever langvarig arbeid og kontroll av egne resultater.
I Cursor er modellen tilgjengelig på betalte abonnementer og bruker kvoten for Cursor Models. Du kan velge low, medium, high eller xhigh som innsatsnivå; standardvalget er high. Dokumentasjonen oppgir 256 000 token i standard kontekstvindu og opptil 500 000 med lang kontekst, der høyere priser gjelder over 256 000 input-token.
Cursor anbefaler Grok 4.7 til vanskeligere oppgaver som tar lengre tid, mens Composer fortsatt er et alternativ for rutinearbeid med vekt på fart og kostnad. Det gir et nyttig utgangspunkt: prøv den nye modellen på en avgrenset, krevende oppgave før du endrer standardmodellen for hele arbeidsdagen.
Kilde: Cursor — Grok 4.7, tilgang og innstillinger
Benchmark: Grok mot GPT og Claude
Tabellen nedenfor gjengir to kodetester fra SpaceXAIs lansering. Høyere prosent er bedre. Dette er leverandørpubliserte resultater, og modellene bruker ulike innsatsnivåer.
| Modell og innsatsnivå | CursorBench 4.0 | Terminal-Bench 4.0 |
|---|---|---|
| Grok 4.7 — xHigh | 46,3 % | 38,0 % |
| Grok 4.6 — High | 40,4 % | 20,3 % |
| GPT-5.6 Sol — Max | 41,7 % | 37,3 % |
| Claude Fable 5.1 — Max | 51,8 % | 57,9 % |
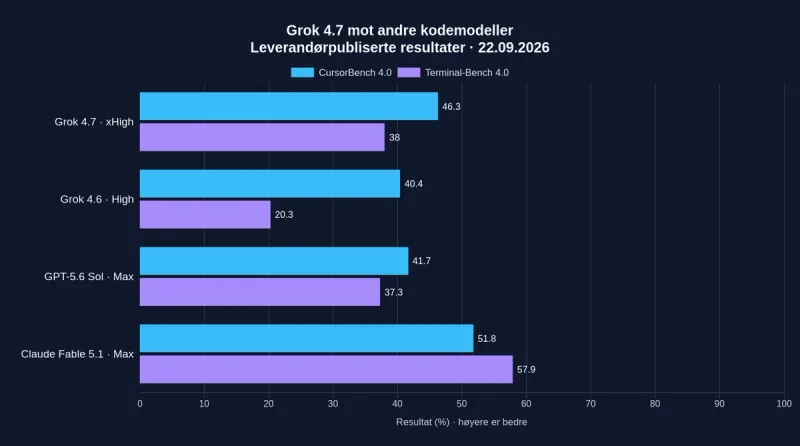
I dette utvalget forbedrer Grok 4.7 resultatene fra 4.6 og ligger foran GPT-5.6 Sol. Fable 5.1 har høyest resultat på begge testene. Tabellen viser derfor fremgang for Grok, uten å gi grunnlag for å kalle modellen best på alle kodeoppgaver.
Kilde: SpaceXAI — Introducing Grok 4.7
Hva viser de uavhengige testene?
Artificial Analysis gir Grok 4.7 med xhigh 56 poeng på sin Coding Agent Index når modellen kjører i Grok Build. Det er opp fra 47 for Grok 4.6 med xhigh. Blant modellene i sine egne agentverktøy plasserer testen Grok bak Claude Fable 5.1, GPT-6 Astra og Claude Opus 5.
Dette må leses som en vurdering av kombinasjonen modell og agentverktøy. Resultatet er ikke en måling av Grok i Cursor. Verktøyene modellen får bruke, og måten oppgaven kjøres på, er en del av testen.
Kilde: Artificial Analysis — Benchmarking Grok 4.7
Google: Gemini 3.8 Flash satser på lange arbeidsoppgaver
Gemini 3.8 Flash ble lansert 2. september. Google retter modellen mot programvareutvikling, autonome agenter og arbeidsflyter med flere trinn. Dokumentasjonen oppgir opptil 1 048 576 input-token og støtte for blant annet verktøykall, kodekjøring og strukturerte svar. Modellen kan ta imot tekst, bilder, video, lyd og PDF, men leverer tekst.
Kilde: Google — Gemini 3.8 Flash, modellspesifikasjoner
Lanseringsprisen er 0,75 dollar per million input-token og 3,75 dollar per million output-token. Google oppgir at introduksjonsprisen gjelder ut 2026; fra 1. januar 2027 er de annonserte satsene 1,50 og 7,50 dollar. Dette er API-priser, ikke prisen på et komplett abonnement eller en ferdig oppgave.
Samtidig kom Gemini 3.8 Flash Cyber for sikkerhetsarbeid. Tilgangen går gjennom Fairwind-programmet for utvalgte forsvarsmiljøer. Den bør derfor omtales separat fra Flash-modellen utviklere kan ta i bruk i vanlige arbeidsflyter.
Kilde: Google — lanseringen av Gemini 3.8 Flash og Flash Cyber
Grok og Gemini: kvalitet må vurderes sammen med kostnad
Artificial Analysis har også en direkte sammenligning av modellene. Tabellen viser deres Intelligence Index og vektede gjennomsnittskostnad per oppgave i denne testen, avlest 22. september. Indekspoengene er ikke prosent og må ikke blandes med kodetestene ovenfor.
| Modell og innsatsnivå | Intelligence Index | Kostnad per testoppgave |
|---|---|---|
| Grok 4.7 — xhigh | 46 | 3,74 USD |
| Grok 4.7 — high | 46 | 2,73 USD |
| Gemini 3.8 Flash — high | 41 | 1,24 USD |
| Gemini 3.8 Flash — medium | 40 | 0,93 USD |
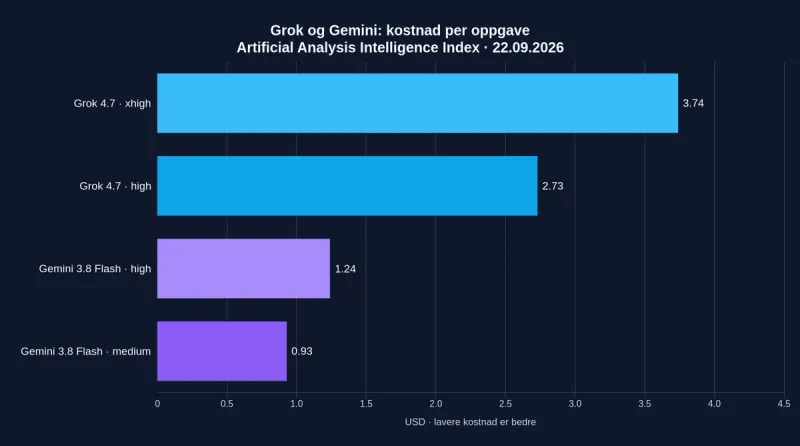
Grok har høyere samlet indeks i denne sammenligningen, mens Gemini koster mindre per testoppgave. Like avrundede poeng for Groks to innsatsnivåer betyr heller ikke at de presterer identisk på hver deltest. Kostnadene gjelder denne testpakken og er ingen prisgaranti for ditt prosjekt.
Kilde: Artificial Analysis — Grok 4.7 sammenlignet med Gemini 3.8 Flash
Google har også nye stemmemodeller og en oppdatert agent
Den 15. september kom Gemini 3.8 Live og Live Extended Thinking. Disse er laget for samtaler i sanntid. Extended Thinking kan arbeide videre med mer sammensatte oppgaver i bakgrunnen mens dialogen fortsetter. Det er relevant for taleassistenter og kundedialog, men resultatene fra stemmetester sier ikke hvilken modell som er best til å endre kode.
Kilde: Google — Gemini 3.8 Live og Live Extended Thinking
Googles API-endringslogg viser dessuten en ny Antigravity Agent-preview fra 17. september. For eksisterende integrasjoner er endringer i verktøykall og filredigering verdt å kontrollere før oppgradering. Dette er en oppdatering av agenten, og bør skilles fra lanseringen av selve Flash-modellen.
Kilde: Google — Gemini API-endringslogg
Slik ville vi sammenlignet modellene på et ekte prosjekt
Et nyttig forsøk kan være å rette en bookingfeil: To kunder skal ikke kunne reservere samme tidsrom samtidig. Oppgaven tvinger agenten til å forstå eksisterende kode, håndtere samtidige forespørsler og bevise at rettingen virker.
Gi hver modell samme startpunkt, samme oppgave og samme tilgang til verktøy. Bruk separate kopier av prosjektet, slik at én modell ikke får hjelp av den forriges endringer. Noter modellversjon, innsatsnivå, agentverktøy, tidsbruk og kostnad.
Vurder deretter om løsningen består testene, om den introduserer nye feil, og hvor mye manuell retting som trengs. Registrer også avbrutte forsøk. En rask demonstrasjon som krever en time med opprydding, kan være mindre verdifull enn en langsommere løsning du kan godkjenne med få endringer.
Et prompt du kan prøve
«Undersøk hvordan prosjektet håndterer reservasjoner. Rett feilen som gjør at to samtidige forespørsler kan bestille samme ressurs i samme tidsrom. Følg prosjektets eksisterende mønstre. Lag en test som gjenskaper feilen, implementer rettingen og kjør relevante tester. Oppsummer endrede filer, testresultater og gjenstående usikkerhet. Hvis du ikke kan kjøre testene, forklar hvorfor. Ikke publiser eller deploy endringene.»
Bruk promptet som et utgangspunkt og legg til prosjektets faktiske krav. Avklar for eksempel om avbestillinger, tidssoner eller flere avdelinger påvirker hva som teller som en konflikt.
Hva betyr dette for modellvalget ditt?
Vår vurdering er at de nye lanseringene gir flere kandidater å prøve, men at oppgaven fortsatt bør styre valget. Start med et lite sett representative problemer fra din egen hverdag. Velg modellen og agentverktøyet som gir pålitelig resultat med akseptabel kostnad og minst behov for etterarbeid.
Den mest interessante målingen er hvor mye arbeid du faktisk får ferdig og kan stole på. Benchmarkene hjelper deg å velge hva du skal teste først.