Grok 4.7 y Gemini 3.8: Nuevos lanzamientos de IA y sus benchmarks
Abres tu proyecto, eliges un modelo de IA y le asignas una tarea. Pero ¿qué modelo debería encargarse de un cambio que afecta a la base de datos, la lógica de negocio y las pruebas? Septiembre ha traído más opciones para los desarrolladores y más cifras que interpretar.
Grok 4.7 ha llegado a Cursor. Google ha lanzado Gemini 3.8 Flash y nuevos modelos para conversaciones en tiempo real. Repasamos qué ha cambiado, cómo interpretar los benchmarks y cómo comparar los modelos con tareas que realmente te importan.
Actualizado el 22 de septiembre de 2026. Este artículo se basa en la documentación de los proveedores y en pruebas publicadas por Artificial Analysis. Kodemagisk no ha realizado una prueba comparativa propia de los productos.
Grok 4.7: un nuevo candidato para tareas de programación exigentes
SpaceXAI lanzó Grok 4.7 el 21 de septiembre. La empresa describe un modelo base más grande y un entrenamiento orientado a tareas que requieren trabajo prolongado y comprobación de sus propios resultados.
En Cursor, el modelo está disponible en los planes de pago y consume la cuota de Cursor Models. Puedes elegir entre los niveles de esfuerzo de razonamiento low, medium, high y xhigh; high es la opción predeterminada. La documentación indica una ventana de contexto estándar de 256.000 tokens y hasta 500.000 con contexto largo, con tarifas más altas por encima de 256.000 tokens de entrada.
Cursor recomienda Grok 4.7 para tareas más difíciles y prolongadas, mientras que Composer sigue siendo una opción para el trabajo rutinario donde importan la velocidad y el coste. Es un buen punto de partida: prueba el nuevo modelo con una tarea exigente y bien delimitada antes de cambiar tu modelo predeterminado para toda la jornada.
Fuente: Cursor — Grok 4.7, acceso y configuración
Benchmarks: Grok frente a GPT y Claude
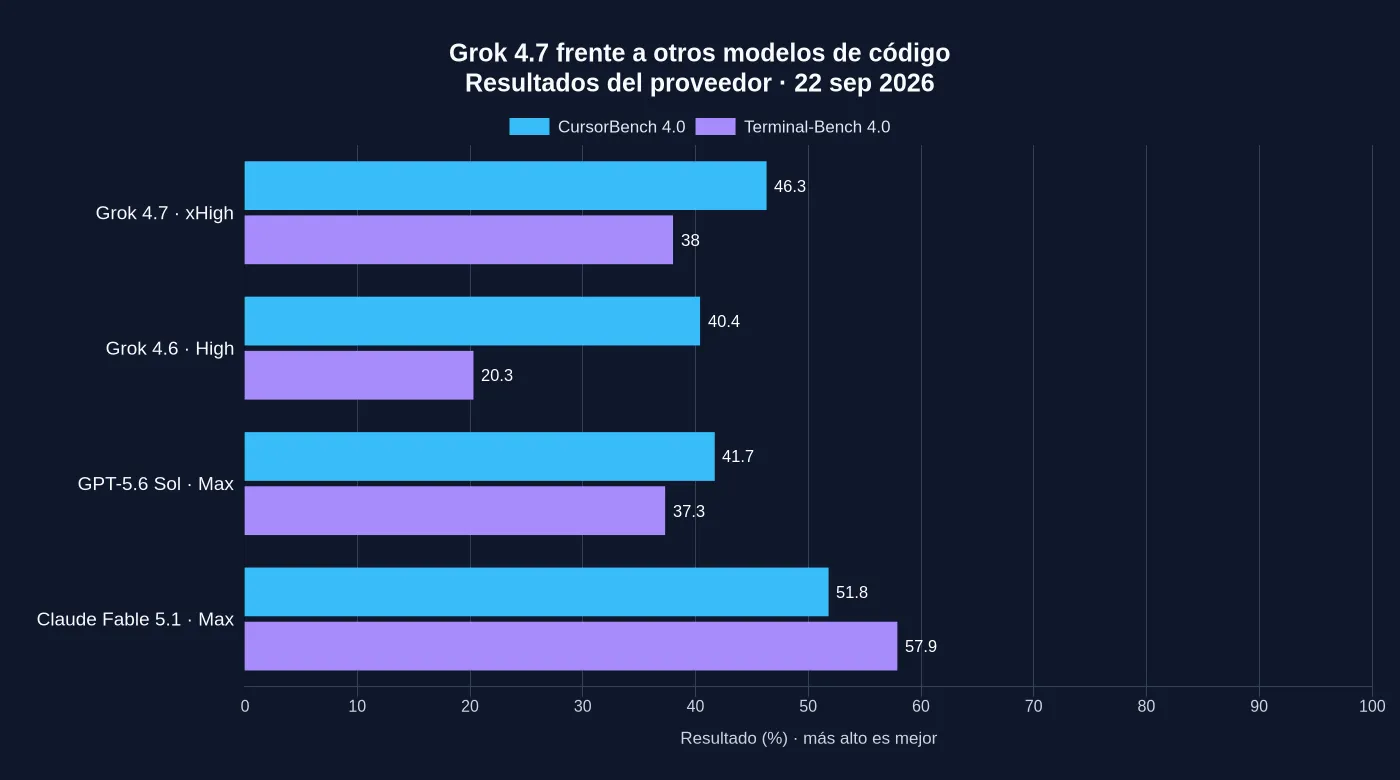
La siguiente tabla reproduce dos pruebas de programación del anuncio de SpaceXAI. Un porcentaje mayor indica un mejor resultado. Son cifras publicadas por el proveedor y los modelos utilizan distintos niveles de esfuerzo de razonamiento.
| Modelo y esfuerzo de razonamiento | CursorBench 4.0 | Terminal-Bench 4.0 |
|---|---|---|
| Grok 4.7 — xHigh | 46,3 % | 38,0 % |
| Grok 4.6 — High | 40,4 % | 20,3 % |
| GPT-5.6 Sol — Max | 41,7 % | 37,3 % |
| Claude Fable 5.1 — Max | 51,8 % | 57,9 % |
En esta selección, Grok 4.7 mejora los resultados de 4.6 y supera a GPT-5.6 Sol. Fable 5.1 obtiene la puntuación más alta en ambas pruebas. La tabla muestra un avance de Grok, pero no permite afirmar que sea el mejor modelo para cualquier tarea de programación.
Fuente: SpaceXAI — presentación de Grok 4.7
¿Qué muestran las pruebas independientes?
Artificial Analysis otorga a Grok 4.7 con xhigh 56 puntos en su Coding Agent Index cuando funciona en Grok Build, frente a los 47 de Grok 4.6 con xhigh. Entre los modelos evaluados con sus propias herramientas de agente, la prueba sitúa a Grok por detrás de Claude Fable 5.1, GPT-6 Astra y Claude Opus 5.
El resultado evalúa la combinación del modelo y la herramienta de agente. No es una medición de Grok dentro de Cursor. Las herramientas disponibles y la forma de ejecutar la tarea también forman parte de la prueba.
Fuente: Artificial Analysis — evaluación de Grok 4.7
Google: Gemini 3.8 Flash apuesta por flujos de trabajo prolongados
Gemini 3.8 Flash se lanzó el 2 de septiembre. Google lo orienta al desarrollo de software, los agentes autónomos y los flujos de trabajo de varios pasos. La documentación indica hasta 1.048.576 tokens de entrada y funciones como llamadas a herramientas, ejecución de código y respuestas estructuradas. Acepta texto, imágenes, vídeo, audio y PDF, y genera texto.
Fuente: Google — especificaciones de Gemini 3.8 Flash
El precio de lanzamiento es de 0,75 dólares por millón de tokens de entrada y 3,75 dólares por millón de tokens de salida. Google indica que esta tarifa estará vigente hasta finales de 2026; a partir del 1 de enero de 2027, las tarifas anunciadas son de 1,50 y 7,50 dólares. Son precios de la API, no el coste de una suscripción completa ni de una tarea terminada.
También se presentó Gemini 3.8 Flash Cyber para tareas de seguridad. El acceso se ofrece mediante el programa Fairwind a equipos de defensa seleccionados. Conviene tratarlo por separado del modelo Flash que los desarrolladores pueden utilizar en sus flujos de trabajo habituales.
Fuente: Google — lanzamiento de Gemini 3.8 Flash y Flash Cyber
Grok y Gemini: valorar la calidad junto con el coste
Artificial Analysis también ofrece una comparación directa de estos modelos. La tabla muestra su Intelligence Index y el coste medio ponderado por tarea en esa prueba, consultados el 22 de septiembre. Los puntos del índice no son porcentajes y no deben mezclarse con las pruebas de programación anteriores.
| Modelo y esfuerzo de razonamiento | Intelligence Index | Coste por tarea de prueba |
|---|---|---|
| Grok 4.7 — xhigh | 46 | 3,74 USD |
| Grok 4.7 — high | 46 | 2,73 USD |
| Gemini 3.8 Flash — high | 41 | 1,24 USD |
| Gemini 3.8 Flash — medium | 40 | 0,93 USD |
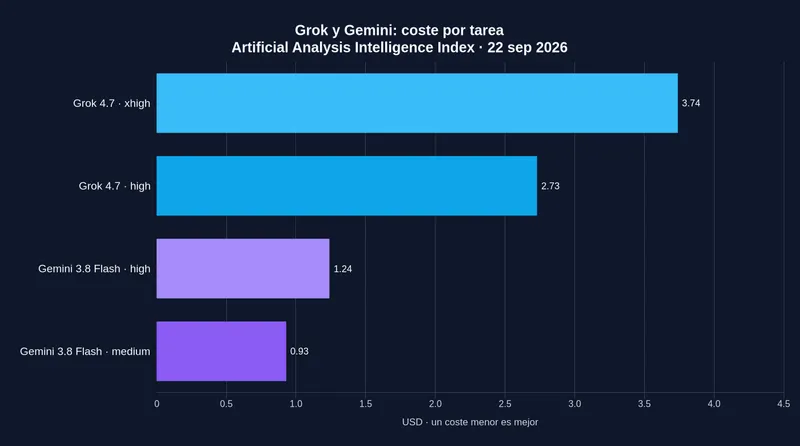
Grok obtiene un índice global mayor en esta comparación, mientras que Gemini cuesta menos por tarea evaluada. Que los dos niveles de Grok tengan la misma puntuación redondeada tampoco significa que rindan igual en cada subprueba. Los costes corresponden a esta batería de pruebas y no garantizan el precio de tu proyecto.
Fuente: Artificial Analysis — comparación de Grok 4.7 y Gemini 3.8 Flash
Google también presenta nuevos modelos de voz y una actualización de su agente
Gemini 3.8 Live y Live Extended Thinking llegaron el 15 de septiembre. Están diseñados para conversaciones en tiempo real. Extended Thinking puede seguir trabajando en tareas más complejas en segundo plano mientras continúa la conversación. Esto resulta relevante para asistentes de voz y atención al cliente, pero los resultados de las pruebas de voz no determinan qué modelo es mejor para modificar código.
Fuente: Google — Gemini 3.8 Live y Live Extended Thinking
El registro de cambios de la API de Google también recoge una nueva versión preliminar de Antigravity Agent del 17 de septiembre. En las integraciones existentes, conviene revisar los cambios en las llamadas a herramientas y la edición de archivos antes de actualizar. Se trata de una actualización del agente, distinta del lanzamiento del propio modelo Flash.
Fuente: Google — registro de cambios de la API de Gemini
Cómo compararíamos los modelos en un proyecto real
Un experimento útil sería corregir un error de reservas: dos clientes no deberían poder reservar simultáneamente la misma franja horaria. La tarea obliga al agente a comprender el código existente, gestionar peticiones concurrentes y demostrar que la corrección funciona.
Proporciona a cada modelo el mismo punto de partida, la misma tarea y el mismo acceso a herramientas. Utiliza copias independientes del proyecto para que ningún modelo aproveche los cambios del anterior. Registra la versión del modelo, el nivel de esfuerzo, la herramienta de agente, el tiempo empleado y el coste.
Después, comprueba si la solución supera las pruebas, introduce nuevos errores y requiere correcciones manuales. Registra también los intentos abandonados. Una demostración rápida que exige una hora de retoques puede aportar menos que una solución más lenta que puedes aprobar con pocos cambios.
Un prompt que puedes probar
«Investiga cómo gestiona las reservas este proyecto. Corrige el error que permite que dos peticiones concurrentes reserven el mismo recurso en la misma franja horaria. Sigue los patrones existentes del proyecto. Crea una prueba que reproduzca el error, implementa la corrección y ejecuta las pruebas pertinentes. Resume los archivos modificados, los resultados de las pruebas y las dudas pendientes. Si no puedes ejecutar las pruebas, explica por qué. No publiques ni despliegues los cambios».
Utiliza el prompt como punto de partida y añade los requisitos reales del proyecto. Por ejemplo, aclara si las cancelaciones, las zonas horarias o la existencia de varias sedes afectan a lo que se considera un conflicto.
¿Qué implica esto para elegir tu modelo?
Nuestra valoración es que estos lanzamientos ofrecen más candidatos que probar, aunque la tarea debe seguir guiando la elección. Empieza con un pequeño conjunto de problemas representativos de tu trabajo. Elige el modelo y la herramienta de agente que ofrezcan resultados fiables a un coste aceptable y con la menor necesidad de correcciones posteriores.
La medida más útil es cuánto trabajo consigues terminar y puedes dar por bueno. Los benchmarks te ayudan a decidir qué probar primero.