Grok 4.7 și Gemini 3.8: Noile lansări AI și benchmarkurile din spatele lor
Deschizi proiectul, alegi un model de inteligență artificială și îi dai o sarcină. Dar ce model ar trebui să se ocupe de o modificare care afectează baza de date, logica aplicației și testele? Septembrie le-a adus dezvoltatorilor mai multe opțiuni, dar și mai multe cifre de interpretat.
Grok 4.7 a ajuns în Cursor. Google a lansat Gemini 3.8 Flash și modele noi pentru conversații în timp real. Analizăm ce s-a schimbat, cum trebuie citite benchmarkurile și cum poți compara modelele pe sarcini relevante pentru munca ta.
Actualizat la 22 septembrie 2026. Articolul se bazează pe documentația producătorilor și pe testele publicate de Artificial Analysis. Kodemagisk nu a realizat un test comparativ propriu al produselor.
Grok 4.7: un nou candidat pentru sarcini dificile de programare
SpaceXAI a lansat Grok 4.7 pe 21 septembrie. Compania descrie un model de bază mai mare și un antrenament orientat spre sarcini care necesită lucru îndelungat și verificarea propriilor rezultate.
În Cursor, modelul este disponibil în abonamentele plătite și consumă din cota Cursor Models. Poți alege nivelul de efort de raționament low, medium, high sau xhigh; opțiunea implicită este high. Documentația indică o fereastră de context standard de 256.000 de tokenuri și până la 500.000 în modul cu context lung, cu tarife mai mari peste 256.000 de tokenuri de intrare.
Cursor recomandă Grok 4.7 pentru sarcini mai dificile și de durată, în timp ce Composer rămâne o opțiune pentru activități de rutină, unde contează viteza și costul. Este un punct de plecare util: încearcă noul model pe o sarcină dificilă, bine delimitată, înainte să îl alegi ca model implicit pentru întreaga zi de lucru.
Sursă: Cursor — Grok 4.7, acces și configurare
Benchmarkuri: Grok în comparație cu GPT și Claude
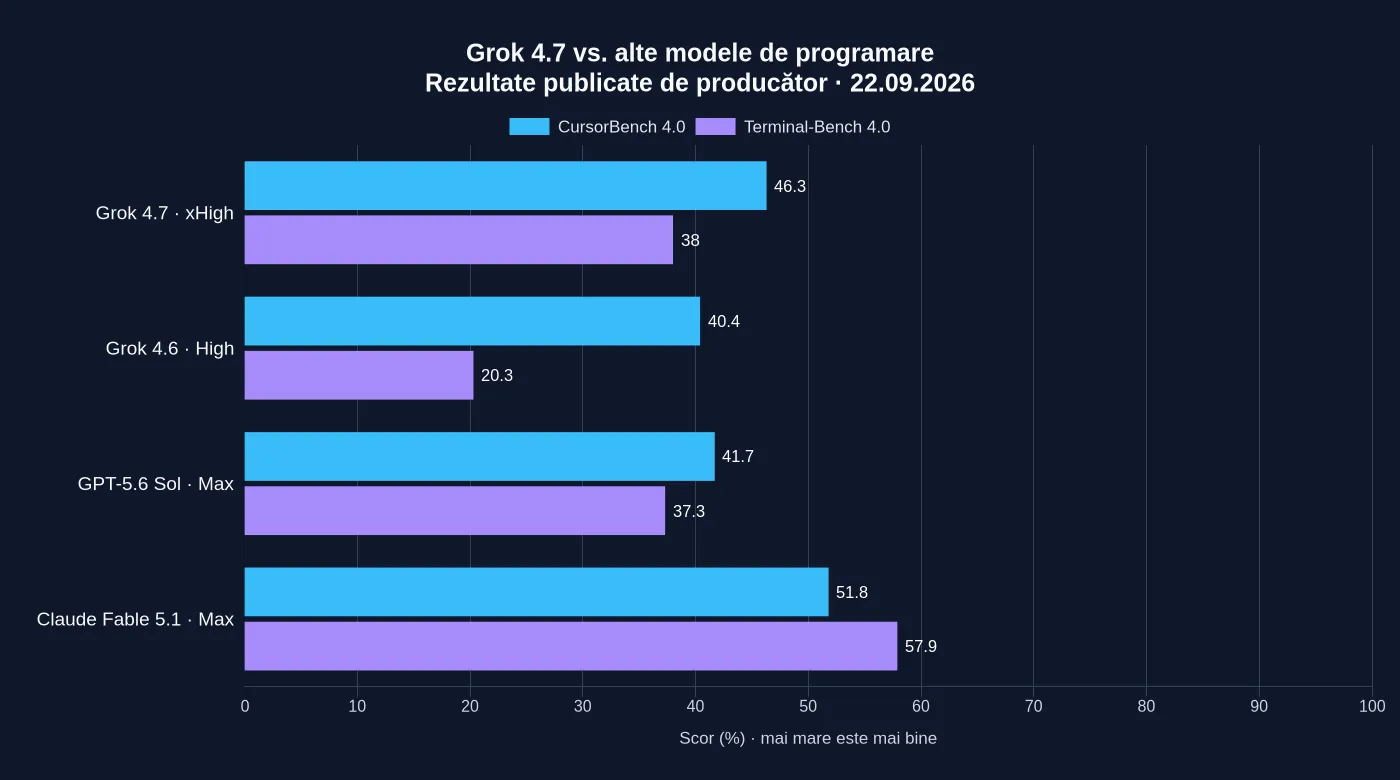
Tabelul de mai jos reproduce două teste de programare din anunțul SpaceXAI. Un procent mai mare înseamnă un rezultat mai bun. Cifrele sunt publicate de producător, iar modelele folosesc niveluri diferite de efort de raționament.
| Model și efort de raționament | CursorBench 4.0 | Terminal-Bench 4.0 |
|---|---|---|
| Grok 4.7 — xHigh | 46,3 % | 38,0 % |
| Grok 4.6 — High | 40,4 % | 20,3 % |
| GPT-5.6 Sol — Max | 41,7 % | 37,3 % |
| Claude Fable 5.1 — Max | 51,8 % | 57,9 % |
În această selecție, Grok 4.7 îmbunătățește rezultatele versiunii 4.6 și depășește GPT-5.6 Sol. Fable 5.1 obține cel mai mare scor în ambele teste. Tabelul arată progresul Grok, fără să demonstreze că este cel mai bun model pentru orice sarcină de programare.
Sursă: SpaceXAI — prezentarea Grok 4.7
Ce arată testele independente?
Artificial Analysis acordă modelului Grok 4.7, cu nivelul xhigh, 56 de puncte în Coding Agent Index atunci când rulează în Grok Build, față de 47 pentru Grok 4.6 cu xhigh. Dintre modelele evaluate în propriile instrumente de agent, testul plasează Grok în urma Claude Fable 5.1, GPT-6 Astra și Claude Opus 5.
Rezultatul trebuie înțeles ca o evaluare a combinației dintre model și instrumentul de agent. Nu reprezintă o măsurare a Grok în Cursor. Instrumentele la care are acces modelul și modul în care este executată sarcina fac parte din test.
Sursă: Artificial Analysis — evaluarea Grok 4.7
Google: Gemini 3.8 Flash vizează fluxuri de lucru de durată
Gemini 3.8 Flash a fost lansat pe 2 septembrie. Google îl poziționează pentru dezvoltare software, agenți autonomi și fluxuri de lucru cu mai mulți pași. Documentația indică până la 1.048.576 de tokenuri de intrare și funcții precum apelarea instrumentelor, executarea codului și răspunsuri structurate. Modelul acceptă text, imagini, video, audio și PDF, iar răspunsurile sunt text.
Sursă: Google — specificațiile Gemini 3.8 Flash
Prețul introductiv este de 0,75 dolari pentru un milion de tokenuri de intrare și 3,75 dolari pentru un milion de tokenuri de ieșire. Google precizează că acest tarif este valabil până la sfârșitul anului 2026; începând cu 1 ianuarie 2027, tarifele anunțate sunt de 1,50 și 7,50 dolari. Acestea sunt prețuri API, nu costul unui abonament complet sau al unei sarcini finalizate.
A fost lansat și Gemini 3.8 Flash Cyber, pentru activități de securitate. Accesul se acordă prin programul Fairwind unor echipe de apărare selectate. De aceea, trebuie prezentat separat de modelul Flash pe care dezvoltatorii îl pot folosi în fluxurile obișnuite de lucru.
Sursă: Google — lansarea Gemini 3.8 Flash și Flash Cyber
Grok și Gemini: calitatea trebuie evaluată împreună cu costul
Artificial Analysis oferă și o comparație directă între modele. Tabelul prezintă Intelligence Index și costul mediu ponderat per sarcină în acel test, consultate pe 22 septembrie. Punctele indicelui nu sunt procente și nu trebuie confundate cu testele de programare de mai sus.
| Model și efort de raționament | Intelligence Index | Cost per sarcină de test |
|---|---|---|
| Grok 4.7 — xhigh | 46 | 3,74 USD |
| Grok 4.7 — high | 46 | 2,73 USD |
| Gemini 3.8 Flash — high | 41 | 1,24 USD |
| Gemini 3.8 Flash — medium | 40 | 0,93 USD |
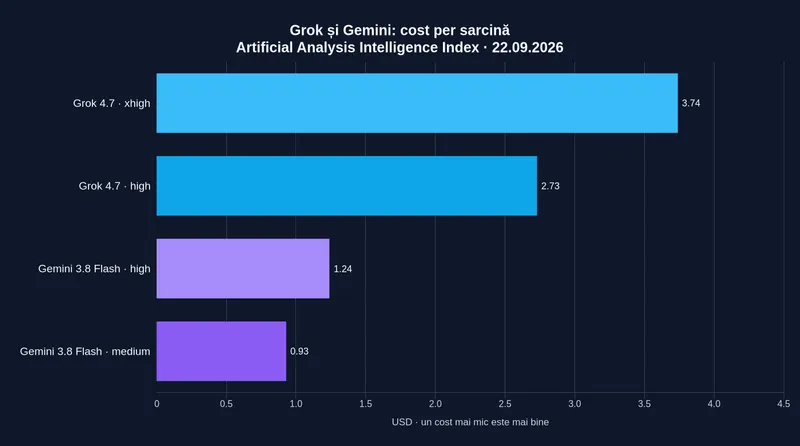
Grok obține un indice general mai mare în această comparație, în timp ce Gemini costă mai puțin per sarcină de test. Scorurile rotunjite identice ale celor două niveluri Grok nu înseamnă că performanța este aceeași în fiecare subtest. Costurile se referă la această suită de teste și nu garantează prețul pentru proiectul tău.
Sursă: Artificial Analysis — Grok 4.7 comparat cu Gemini 3.8 Flash
Google are și modele noi de voce și un agent actualizat
Gemini 3.8 Live și Live Extended Thinking au fost lansate pe 15 septembrie. Sunt concepute pentru conversații în timp real. Extended Thinking poate continua să lucreze în fundal la sarcini mai complexe, în timp ce dialogul merge mai departe. Acest lucru este relevant pentru asistenți vocali și interacțiuni cu clienții, dar rezultatele testelor de voce nu stabilesc ce model este mai bun la modificarea codului.
Sursă: Google — Gemini 3.8 Live și Live Extended Thinking
Jurnalul de modificări al API-ului Google include și o nouă versiune preview a Antigravity Agent, din 17 septembrie. Pentru integrările existente, merită verificate schimbările privind apelarea instrumentelor și editarea fișierelor înainte de actualizare. Este o actualizare a agentului, distinctă de lansarea modelului Flash.
Sursă: Google — jurnalul de modificări al API-ului Gemini
Cum am compara modelele pe un proiect real
Un experiment util ar fi corectarea unei erori de rezervare: doi clienți nu ar trebui să poată rezerva simultan același interval orar. Sarcina obligă agentul să înțeleagă codul existent, să gestioneze cereri concurente și să demonstreze că soluția funcționează.
Oferă fiecărui model același punct de plecare, aceeași sarcină și același acces la instrumente. Folosește copii separate ale proiectului, astfel încât un model să nu beneficieze de modificările celui anterior. Notează versiunea modelului, nivelul de efort, instrumentul de agent, timpul și costul.
Verifică apoi dacă soluția trece testele, introduce erori noi și necesită corecții manuale. Înregistrează și încercările abandonate. O demonstrație rapidă care necesită o oră de corecții poate fi mai puțin valoroasă decât o soluție mai lentă pe care o poți aproba cu puține modificări.
Un prompt pe care îl poți încerca
„Analizează cum gestionează proiectul rezervările. Corectează eroarea care permite ca două cereri concurente să rezerve aceeași resursă în același interval orar. Respectă convențiile existente ale proiectului. Creează un test care reproduce eroarea, implementează corecția și rulează testele relevante. Rezumă fișierele modificate, rezultatele testelor și incertitudinile rămase. Dacă nu poți rula testele, explică de ce. Nu publica și nu face deploy modificărilor.”
Folosește promptul ca punct de plecare și adaugă cerințele reale ale proiectului. De exemplu, clarifică dacă anulările, fusurile orare sau existența mai multor sedii influențează ceea ce se consideră un conflict.
Ce înseamnă toate acestea pentru alegerea modelului?
În opinia noastră, aceste lansări oferă mai mulți candidați de testat, dar sarcina trebuie să rămână criteriul principal de alegere. Începe cu un set mic de probleme reprezentative pentru munca ta. Alege modelul și instrumentul de agent care oferă rezultate fiabile, la un cost acceptabil și cu cât mai puține corecții ulterioare.
Cea mai utilă măsură este câtă muncă finalizezi efectiv și în ce rezultate poți avea încredere. Benchmarkurile te ajută să alegi ce să testezi mai întâi.